오늘 꼭 챙겨볼 3줄 요약 브리핑

바쁜 하루, AI가 핵심만 3줄로 짚어주는 반말뉴스로 빠르게 확인해봐!
멀티턴 강화학습 리워드 함수 잘못 짜면 모델 망한다
알고리즘

멀티턴 강화학습 리워드 함수 잘못 짜면 모델 망한다

  • Amazon Nova Forge를 활용한 멀티턴 강화학습에서 핵심은 결국 커스텀 보상(Reward) 함수 설계라는 거 알고 있었어?
  • 복합 멀티턴 보상 체계를 설계하고, 모델이 생성한 코드를 안전하게 실행하는 실전 기법을 제시해.
  • 보상 함수가 조용히 무너지는 이른바 'Reward Collapse' 붕괴 현상을 예방하는 구성요소별 검증 가이드야.
AWS ML Blog원문 보기
받아적는 족족 LLM이 가다듬어주는 로컬 음성 입력 도구 등장
수익화

받아적는 족족 LLM이 가다듬어주는 로컬 음성 입력 도구 등장

  • Whisper 기반으로 받아적고 LLM이 매끄럽게 다듬어주는 로컬 받아쓰기 도구 Dictata가 GitHub에 올라왔어.
  • 내 컴퓨터에서 직접 돌아가니까 개인정보 유출 걱정 전혀 없이 음성 메모나 원고를 작성할 수 있지.
  • 말은 막 뱉어도 알아서 문맥 맞게 깔끔한 글로 다듬어주니까 타자 치기 귀찮은 사람한테 딱이야.
Hacker News - LLM원문 보기
AI 에이전트끼리 지식 몰아주다가 에러까지 세습되는 잔혹한 실험
라이브러리

AI 에이전트끼리 지식 몰아주다가 에러까지 세습되는 잔혹한 실험

  • GitHub에 LLM 에이전트 간 지식 계승과 에러 전파를 실험한 'The Commons' 프로젝트가 공개됐어.
  • 선대 에이전트가 축적한 지식을 후대가 받아서 쓰는데, 하필 선대의 착각과 오류까지 그대로 유전돼 버려.
  • 멀티 에이전트 시스템에서 오염된 정보가 어떻게 확산되는지 보여주는 아주 흥미로운 연구야.
Hacker News - LLM원문 보기
LLM 학습이 빵 굽는 거랑 똑같다고? 켄트 백의 찰진 비율 정리
커뮤니티

LLM 학습이 빵 굽는 거랑 똑같다고? 켄트 백의 찰진 비율 정리

  • 소프트웨어 대장 켄트 백이 LLM 훈련 과정을 '빵 굽기' 메타포로 아주 알기 쉽게 풀어서 설명했어.
  • 재료 섞기부터 오븐 온도 조절, 속까지 익었는지 확인하는 과정이 거대 언어 모델 학습이랑 소름 돋게 맞아떨어져.
  • 어려운 AI 훈련 개념을 직관적으로 이해하고 싶다면 일독을 권할 만한 글이야.
Hacker News - LLM원문 보기
구글 콘솔은 끝났다, 크롤러와 내 사이트 AI가 직접 대화하는 시대
비즈니스

구글 콘솔은 끝났다, 크롤러와 내 사이트 AI가 직접 대화하는 시대

  • Show HN에 뜬 Embassia는 정적 웹사이트에 AI 에이전트를 달아주는 신개념 서비스야.
  • ChatGPT나 Claude 같은 검색 크롤러가 사이트에 오면 단순 스크래핑 대신 내 에이전트와 깊은 질의응답을 나눠.
  • 덕분에 검색 유저들이 진짜로 궁금해하는 숨은 의도(Intent)를 데이터로 싹 수집할 수 있다는 게 핵심이지.
Hacker News - LLM원문 보기
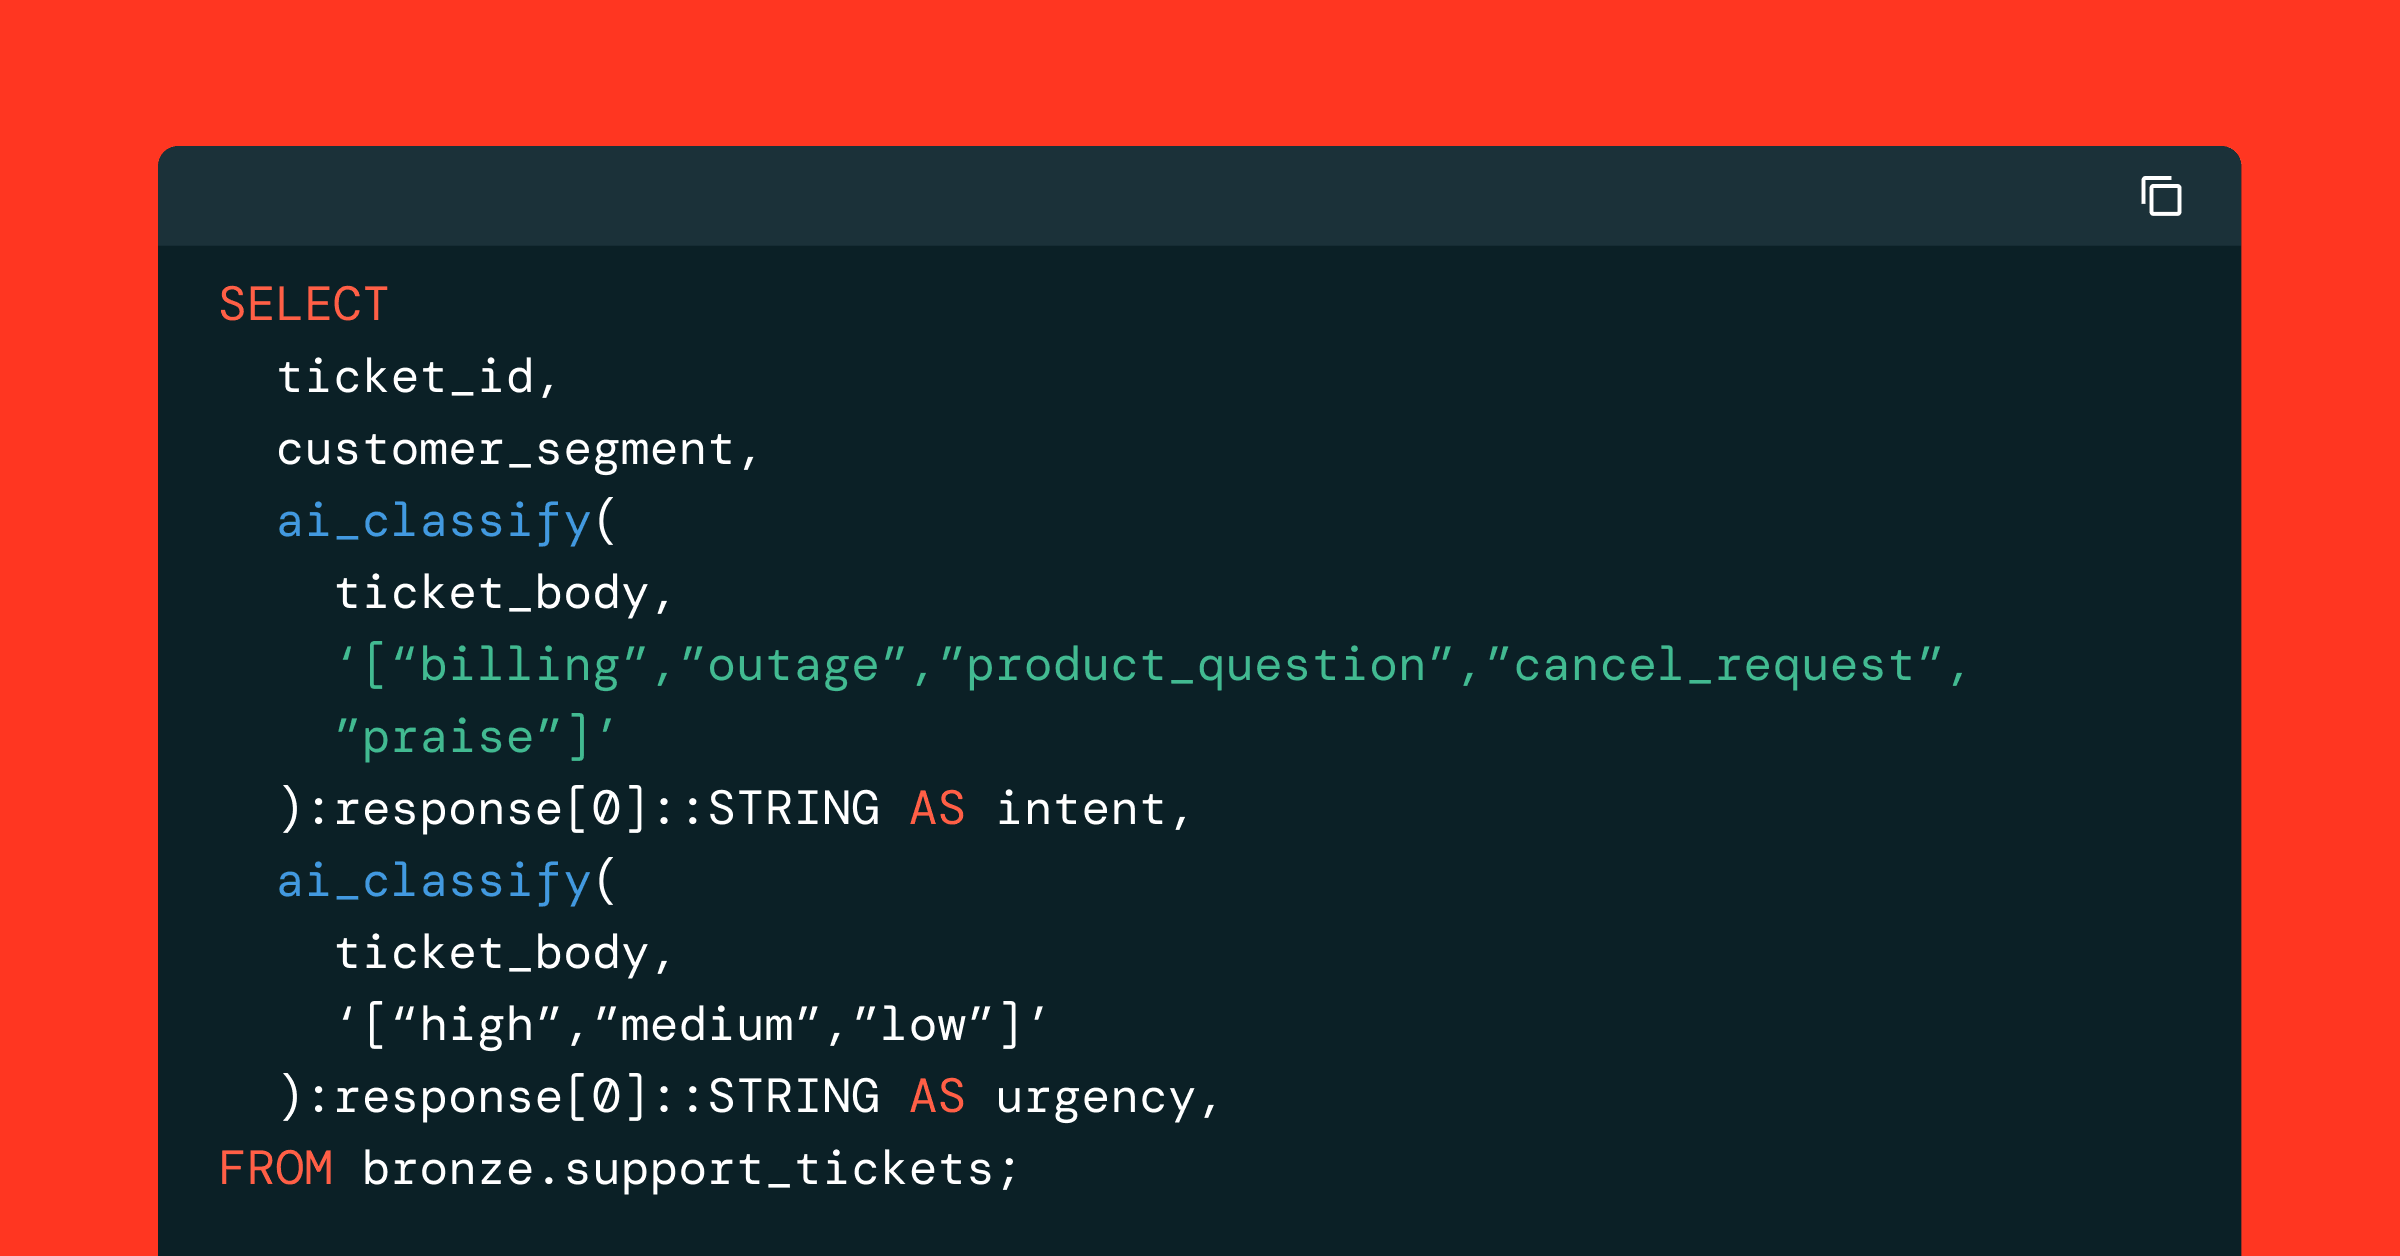
데이터 웨어하우스에 SQL 대신 AI 함수 얹었더니 일어난 일
데이터

데이터 웨어하우스에 SQL 대신 AI 함수 얹었더니 일어난 일

  • 기업 데이터 웨어하우스에 잠자고 있는 비정적 데이터, 이제 SQL 안에 AI_Functions만 쓰면 싹 정리돼.
  • Databricks에서 데이터 웨어하우스 내 AI 함수 활용 베스트 유즈케이스들을 정리해서 가져왔어.
  • 복잡한 파이프라인 안 타고도 텍스트 분류, 요약, 감정분석을 쿼리 한 줄로 처리할 수 있으니 생산성 대폭 향상될 듯.
Databricks Blog원문 보기
좋은 검색엔진 하나보다 멍청해도 검색 여러 번 돌리는 게 낫다고?
생산성

좋은 검색엔진 하나보다 멍청해도 검색 여러 번 돌리는 게 낫다고?

  • OpenRouter에서 LLM 웹 검색 성능 벤치마크 결과를 발표했는데 결과가 아주 흥미로워.
  • 최첨단 검색엔진 하나에 의존하는 것보다, 검색 횟수(Search Call)를 늘려서 긁어모으는 게 답변 품질을 훨씬 높여준대.
  • 검색 퀄리티에 목맬 필요 없이 RAG 에이전트의 검색 루프 설계만 바꿔도 성능이 대폭 상승한다는 뜻이야.
Hacker News - LLM원문 보기
LLM이 헛소리 안 하게 만드는 강화학습 보상 함수 직접 설계하기
알고리즘

LLM이 헛소리 안 하게 만드는 강화학습 보상 함수 직접 설계하기

  • 멀티턴 대화 강화학습에서는 보상 함수(Reward Function)를 어떻게 짜느냐가 모델의 버릇을 결정해.
  • Amazon Nova Forge를 활용해 복합 보상 함수를 만들고 모델이 생성한 코드를 안전하게 실행하는 실전 기법이 나왔어.
  • 잘못 설계하면 보상 체계가 붕괴해서 모델이 꼼수만 배우는데, 이걸 방지하는 예방주사 모니터링법도 공개했지.
AWS ML Blog원문 보기
남들 말만 믿지 마, LLM 추론 벤치마크 직접 돌려봐야 하는 이유
인프라

남들 말만 믿지 마, LLM 추론 벤치마크 직접 돌려봐야 하는 이유

  • 클라우드 업체들이 말하는 LLM 추론 속도 스펙, 실제 내 서비스 얹으면 딴판인 경우가 허다해.
  • DigitalOcean에서 LLM 추론 성능을 제대로 측정하고 벤치마킹하는 구체적인 가이드를 정리해줬어.
  • Latency(대기시간)랑 Throughput(처리량) 사이에서 서비스 특성에 맞는 최적 지점을 찾는 게 핵심이야.
Hacker News - LLM원문 보기
크롤러가 겉할기만 한다고? 웹사이트 에이전트 Embassia 등판
커뮤니티

크롤러가 겉할기만 한다고? 웹사이트 에이전트 Embassia 등판

  • 기존 웹 크롤러나 구글 서치 콘솔로는 방문자가 진짜 뭘 원하는지 깊은 의도를 알 수 없었지.
  • Show HN에 공개된 Embassia는 사이트에 에이전트를 달아 ChatGPT나 Claude 크롤러와 직접 대화하게 만들어.
  • 크롤러가 단순 수집을 넘어 질문을 던지게 해서 진짜 사용자 검색 의도를 파악하는 신개념 도구야.
Hacker News - LLM원문 보기
데이터 웨어하우스에 AI_Functions 끼얹으면 일어나는 일
데이터

데이터 웨어하우스에 AI_Functions 끼얹으면 일어나는 일

  • Databricks 데이터 웨어하우스에 비정형 데이터 다루는 AI_Functions 활용 사례가 정리됐어.
  • 텍스트 요약, 감정 분석, 엔티티 추출 같은 작업을 SQL 쿼리 한 줄로 손쉽게 처리 가능해.
  • 정형 데이터와 비정형 데이터의 경계를 허물어버리는 데이터 팀 필수 무기인 셈이지.
Databricks Blog원문 보기
좋은 검색엔진 하나보다 뼛속까지 긁어모으는 검색 횟수가 장땡
생산성

좋은 검색엔진 하나보다 뼛속까지 긁어모으는 검색 횟수가 장땡

  • OpenRouter가 LLM 웹 검색 벤치마크 결과를 발표했는데 내용이 흥미로워.
  • 검색엔진의 성능을 높이는 것보다, 검색 쿼리를 여러 번 쪼개서 많이 실행하는 게 답변 품질에 훨씬 유리하대.
  • 에이전트 검색 로직 설계할 때 검색 횟수 전략을 재검토해야 할 이유가 생겼네.
Hacker News - LLM원문 보기
LLM이 짠 GPU 커널, 검증기로 꼼꼼하게 털어본다
아키텍처

LLM이 짠 GPU 커널, 검증기로 꼼꼼하게 털어본다

  • LLM으로 GPU 커널 코드를 자동 생성하는 건 좋은데, 버그나 안전성 문제가 늘 걸림돌이었지.
  • arXiv에 계약 기반(Contract-grade)으로 LLM 생성 GPU 커널을 검증하는 연구 논문이 떴어.
  • 코드 성능뿐만 아니라 정밀한 수학적/논리적 검증까지 자동화하는 게 목표라고 해.
Hacker News - LLM원문 보기
Amazon Nova Forge로 강화학습 보상 함수 직접 짜기
알고리즘

Amazon Nova Forge로 강화학습 보상 함수 직접 짜기

  • 멀티턴 강화학습에서는 커스텀 보상 함수(Reward function)가 모델의 성패를 갈라.
  • AWS가 Nova Forge에서 모델이 생성한 코드를 안전하게 실행하며 보상을 계산하는 복합 구조를 제시했어.
  • 보상 함수가 망가져서 모델 학습이 붕괴되는 치명적인 헛점을 방지하는 꿀팁이 핵심이야.
AWS ML Blog원문 보기
내 LLM 추론 속도 왜 이래? 벤치마킹 제대로 하는 기준
인프라

내 LLM 추론 속도 왜 이래? 벤치마킹 제대로 하는 기준

  • DigitalOcean에서 LLM 추론 성능 벤치마킹 기준과 실전 가이드를 정리해 줬어.
  • TTFT(첫 토큰 생성 시간)랑 TPS(초당 토큰 수)를 제대로 측정해야 진짜 인프라 효율이 보여.
  • 클라우드 인프라 선택할 때 가성비 따지려면 이 벤치마크 지표부터 챙겨봐야 함!
Hacker News - LLM원문 보기
빅테크 AI 거두들, 정작 대중이 원하는 게 뭔지 1도 모름
트렌드

빅테크 AI 거두들, 정작 대중이 원하는 게 뭔지 1도 모름

  • 출판 제국을 세웠던 팀 오라일리가 빅테크 AI 출판 생태계 파괴를 직관하며 돌직구를 날렸어.
  • 대형 AI 랩들이 기술 자랑만 할 뿐, 정작 소비자가 진짜 원하는 가치가 뭔지 놓치고 있대.
  • 자신은 오픈소스 AI를 열렬히 지지한다며, 폐쇄적인 빅테크 중심 AI 판도를 제대로 꼬집었지.
Wired (AI)원문 보기
중국서 온 4피트짜리 로봇이 SNS 씹어먹는 중
하드웨어

중국서 온 4피트짜리 로봇이 SNS 씹어먹는 중

  • 유니트리 G1이라는 4피트(약 120cm)짜리 로봇이 틱톡이랑 유튜브를 점령했어.
  • 가격이 비교적 합리적이라 인플루언서들이 춤시키고 묘기 부리게 하면서 유명해진 거지.
  • 근데 귀여운 영상 찍는 건 좋은데, 과연 얘가 실제 현장에서 밥값을 할 수 있을지는 아직 의문이야.
Wired (AI)원문 보기
LLM 추론 속도 지연의 원인? Prefill과 Decode 단계 완벽 해부
알고리즘

LLM 추론 속도 지연의 원인? Prefill과 Decode 단계 완벽 해부

  • LLM 추론 과정은 크게 프롬프트를 한 번에 처리하는 Prefill과 토큰을 하나씩 생성하는 Decode 단계로 나뉘어.
  • Prefill은 컴퓨팅 파워(Compute-bound)를 많이 먹고, Decode는 메모리 대역폭(Memory-bound)의 제약을 크게 받는 차이가 있어.
  • 이 두 단계의 병목 특성을 정확히 이해해야 추론 파이프라인 최적화 및 서빙 비용 절감이 가능해져.
Hacker News - LLM원문 보기
SageMaker와 Bedrock 결합으로 개별 작업 최적화 멀티 에이전트 구축하기
아키텍처

SageMaker와 Bedrock 결합으로 개별 작업 최적화 멀티 에이전트 구축하기

  • AWS가 SageMaker AI의 OpenAI 호환 엔드포인트와 Bedrock AgentCore 런타임을 연동하는 멀티 에이전트 워크플로우를 공개했어.
  • 각 전문 에이전트가 각자 역할에 가장 적합한 최적의 LLM을 골라 쓰도록 아키텍처를 설계할 수 있어.
  • 기본 Strands Agents에서 지원하지 않던 토큰 레벨 관측성(Observability)까지 챙겨서 실무 적용성을 끌어올렸지.
AWS ML Blog원문 보기
빅테크 AI 랩들, 대중이 진짜 원하는 건 1도 모르고 있다는 거장 팁 오라일리의 뼈때리는 일침
트렌드

빅테크 AI 랩들, 대중이 진짜 원하는 건 1도 모르고 있다는 거장 팁 오라일리의 뼈때리는 일침

  • 출판 제국을 세운 IT 거장 팁 오라일리가 빅테크 AI 랩들의 행보를 두고 대중의 니즈를 전혀 파악하지 못하고 있다고 지적했어.
  • 자신이 세운 출판 제국이 AI 때문에 흔들리고 있지만, 오픈소스 형태라면 AI를 여전히 사랑한다고 밝혀 눈길을 끌었지.
  • 결국 폐쇄적인 거대 모델 경쟁보다는 사용자 중심의 오픈소스 생태계가 승리할 거라는 사안의 본질을 짚어낸 셈이야.
Wired (AI)원문 보기